 Walid Karray
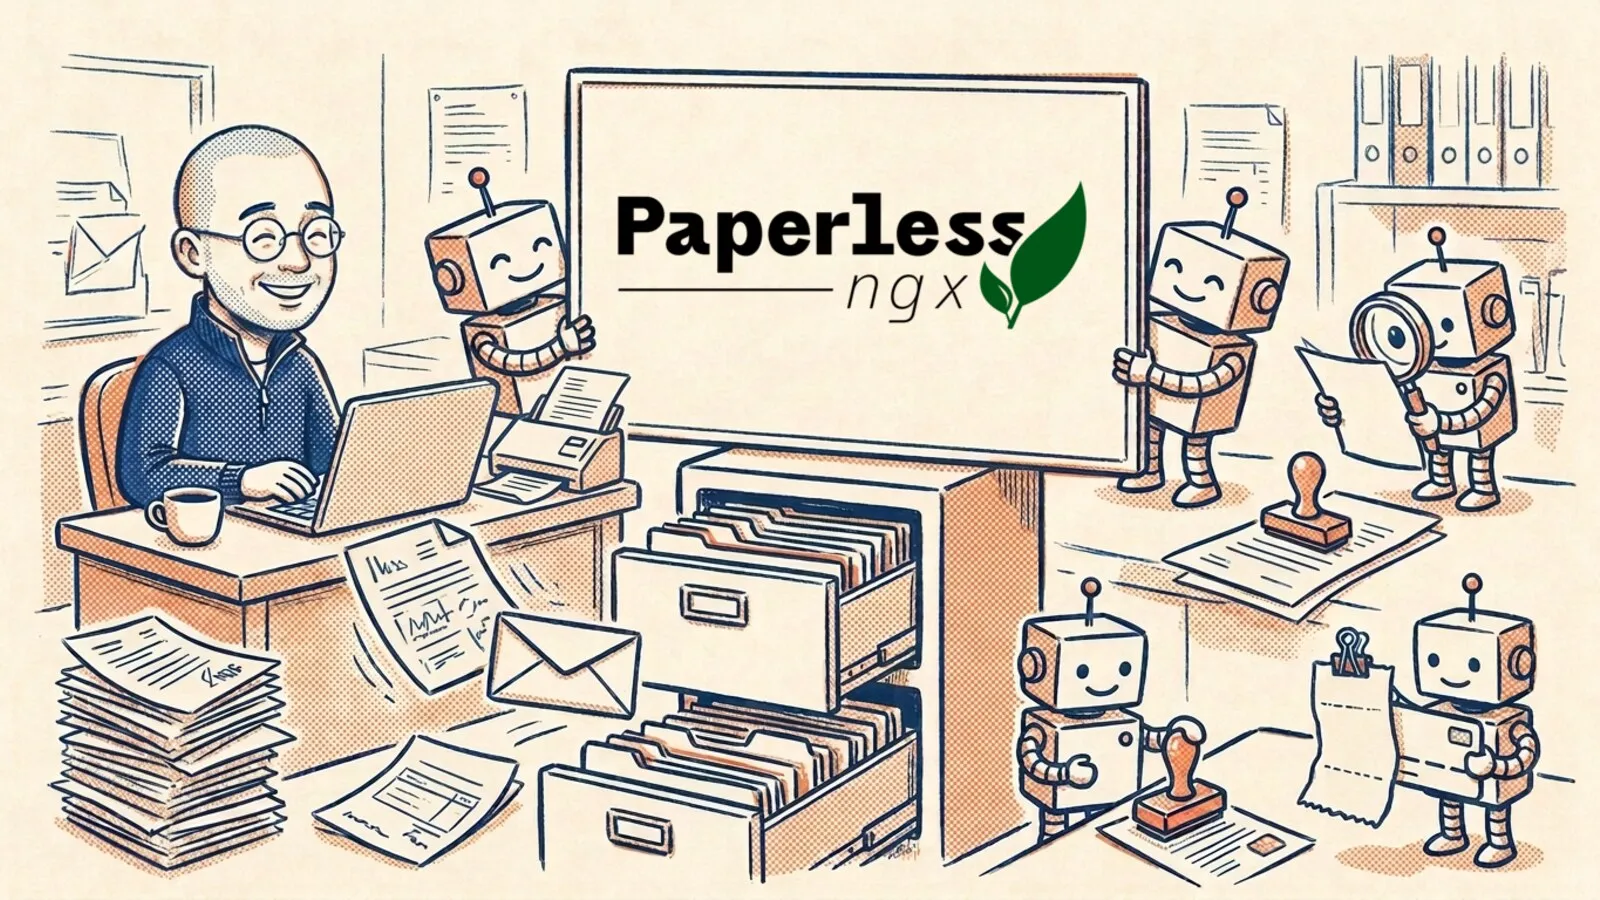
Une facture arrive en PDF dans un mail, en photo de ticket ou sous forme de feuille dans le scanner. Une minute plus tard, un modèle de vision en extrait le fournisseur, la date et le montant. Dans la foulée, un agent repère l’opération en attente sur mon compte bancaire, me soumet le rapprochement, joint la pièce dans Qonto dès que je valide et la relie à son écriture comptable. Sans renommer de fichier, sans ouvrir l’application bancaire, sans saisir de montant.
Mon archive rassemble 890 documents : paie, état civil, santé, contrats, notes de frais et factures d’entreprise. Je ne parcours plus ses dossiers. Un agent dépose les pièces qui entrent, un autre répond à mes questions sur celles qui sont rangées. Chaque brique est cloisonnée au plus juste.
Personne ne classe, et c’est voulu
Paperless-ngx extrait le texte des PDF et des images pour les archiver. Mon instance tourne dans mon homelab (article en anglais), accessible uniquement à travers Tailscale, sans port exposé sur Internet.
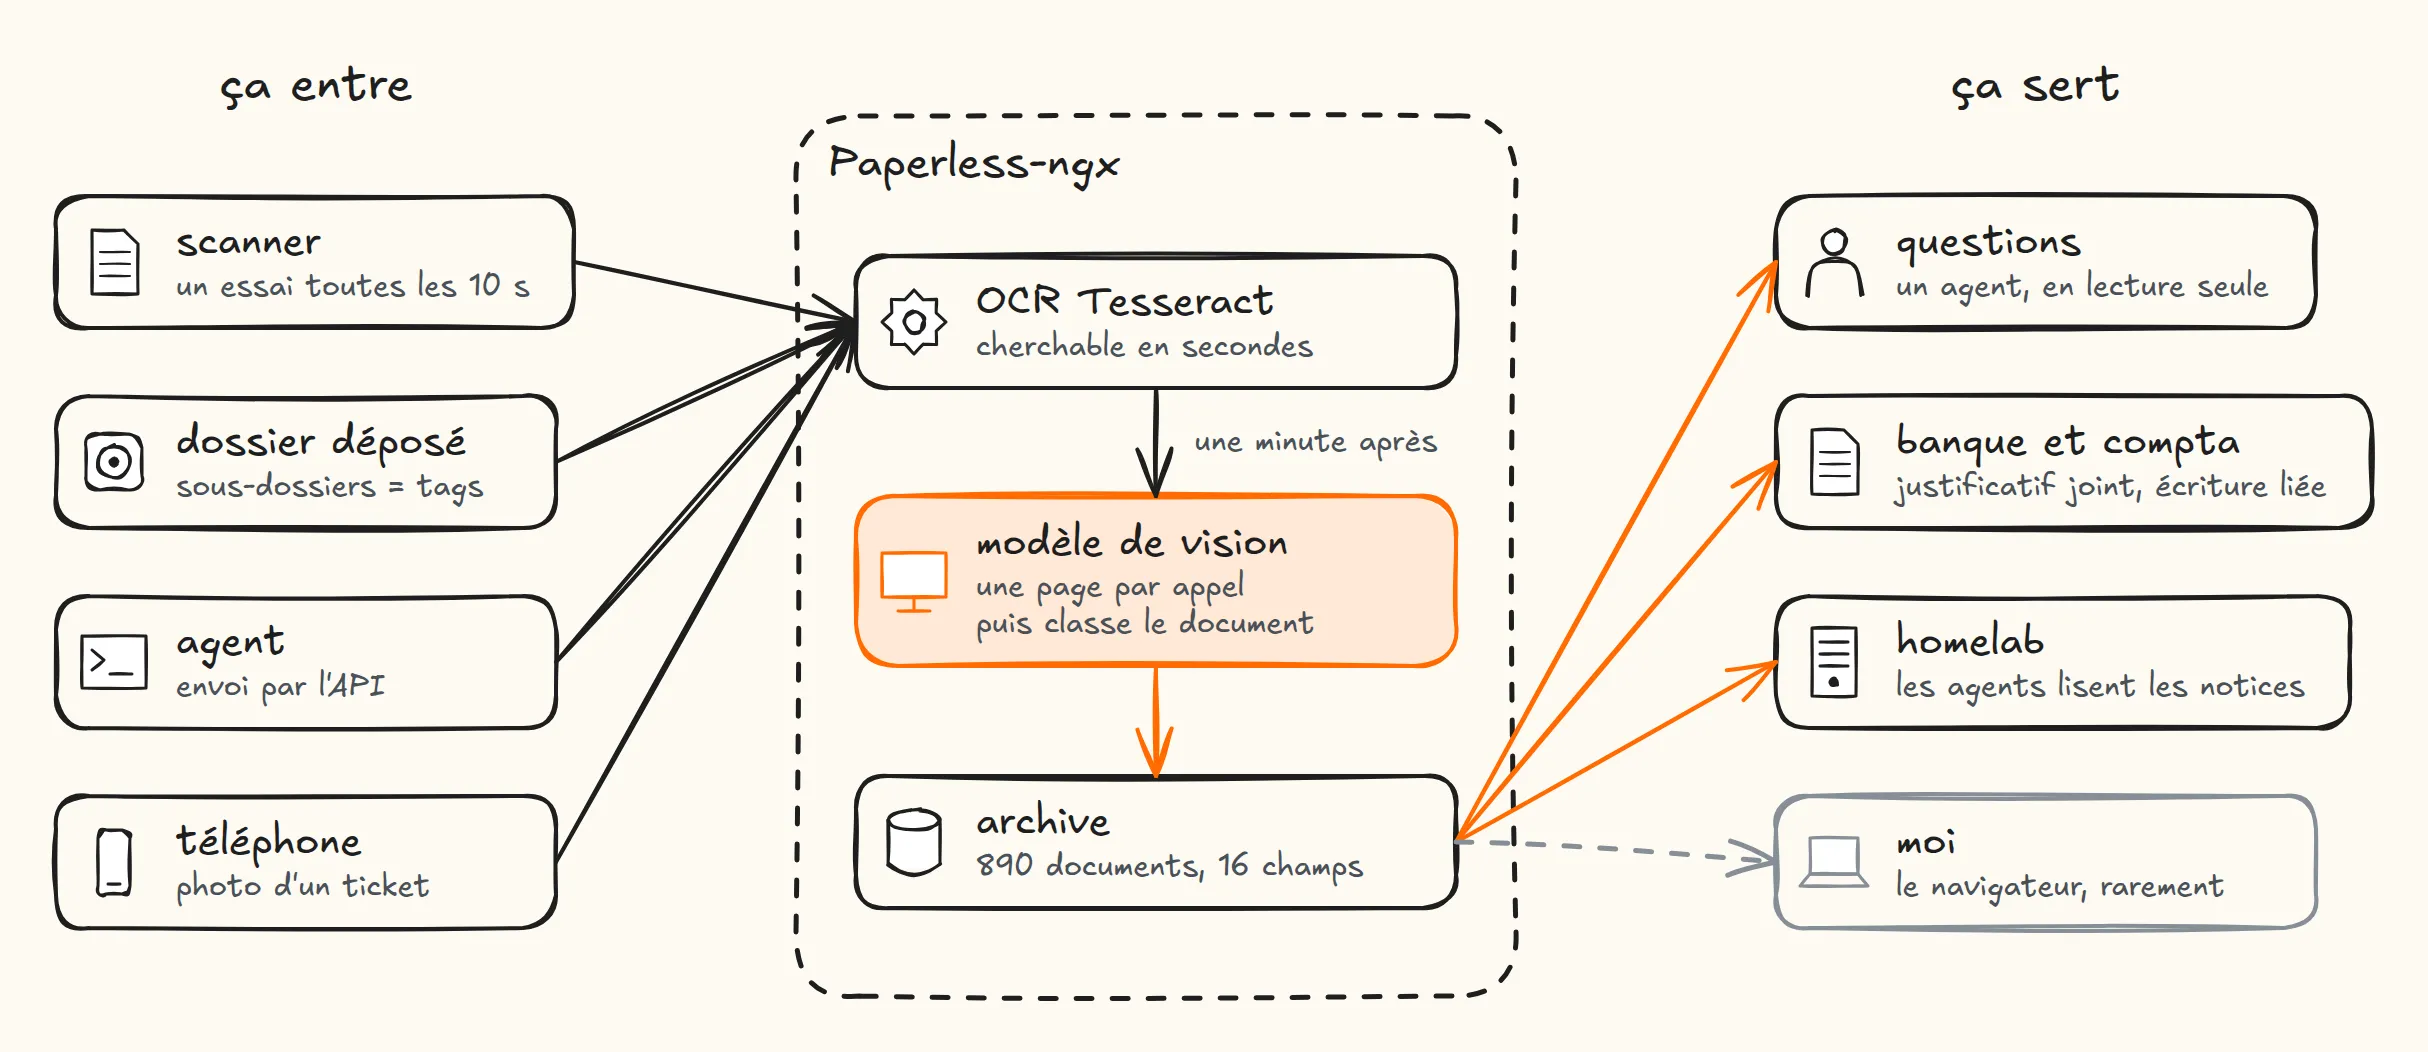
J’ai d’abord désactivé le classificateur automatique de Paperless. Son apprentissage statistique fonctionne bien sur un fournisseur récurrent croisé cinquante fois, mais face à un émetteur inconnu, il devine sans filet. Une archive personnelle est remplie d’émetteurs uniques : mairie, notaire, cabinet médical.
C’est un modèle de vision qui prend le relais. Il relit chaque document une minute après son ingestion, page par page, et sélectionne le type, les étiquettes et l’émetteur dans les listes existantes. Les agents ne passent jamais par l’interface web : ils communiquent par l’API ou un serveur MCP avec des permissions strictement limitées.
Quatre façons d’entrer, sans tri manuel
Le scanner : la tentative de scan sert de capteur
Mon scanner Brother DS-640 est branché en USB sur le serveur. Sans capteur papier logiciel ni bouton d’état, la tentative de scan sert elle-même de détecteur.
Un script shell, lab-autofeed (point d’entrée du conteneur scanservjs), lance scanimage toutes les dix secondes à 300 dpi couleur (--AutoDocumentSize, --AutoDeskew, --SkipBlankPage) :
- Bac vide : le pilote SANE renvoie « out of documents » sans moteur et le script attend 10 secondes.
- Feuille engagée : le scan démarre vers un fichier temporaire
._scan_…pdf, ignoré par Paperless, puis renommé une fois achevé pour éviter d’ingérer un scan incomplet. - Scanner occupé par l’interface web : le pilote renvoie
Device busyet le script patiente 15 secondes. Les bourrages (jammed) sont tracés dans le journal. - Veille USB : quand l’appareil quitte le bus USB puis revient sous un autre numéro, le script le retrouve et redemande son nom à
scanimage -L.
Un fichier autofeed.pause permet de suspendre la boucle. Seule contrainte physique : après une coupure de courant, le scanner doit être réveillé manuellement. Au quotidien, je glisse la feuille dans la fente : elle est avalée dans les dix secondes et atterrit dans l’archive.
Le téléphone : l’application Android sur réseau privé
Pour un ticket ou un courrier reçu en déplacement, l’application Android Paperless se connecte par Tailscale, avec un jeton d’API. En l’absence de date imprimée sur le ticket, le script vision extrait la date de prise de vue dans les métadonnées EXIF (exif_capture_date).
Le dossier déposé et l’API des agents
Pour un lot d’archives existantes, je dépose l’arborescence dans le dossier surveillé par Paperless : chaque sous-dossier devient une étiquette et les doublons sont rejetés. Pour les flux d’entreprise, les agents déposent directement les pièces par l’API REST.
Deux lectures : l’indexation rapide puis la vision fidèle
Tesseract pour la recherche plein texte immédiate
Dès l’ingestion, Tesseract extrait le texte brut (français, anglais, arabe). Le document devient interrogeable en quelques secondes. Mais Tesseract ne saisit pas la structure : sur une note manuscrite, un ticket froissé ou un scan médiocre, il produit du bruit suffisant pour chercher un mot-clé, insuffisant pour extraire des champs fiables.
Le modèle de vision en tâche de fond, page par page
Au démarrage du conteneur, /custom-cont-init.d/50-vision.sh lance la boucle en arrière-plan sous l’utilisateur paperless :
while :; do python3 /opt/vision/paperless-vision.py --pending --apply; sleep 60; doneCe script de 894 lignes travaille directement dans l’ORM Django de Paperless, sans passer par l’API REST. L’option --pending sélectionne les documents sans le champ personnalisé vision ou traités avec une ancienne version. Il traite quatre pages en parallèle, un seul document à la fois.
La règle d’or tient en une ligne : une page par appel, jamais un document entier. Sur un relevé bancaire de 28 pages, envoyer le fichier complet poussait le modèle à condenser le texte : il renvoyait 43 caractères par page, contre 2 568 pour Tesseract. Le modèle résumait en silence pour s’adapter à la charge.
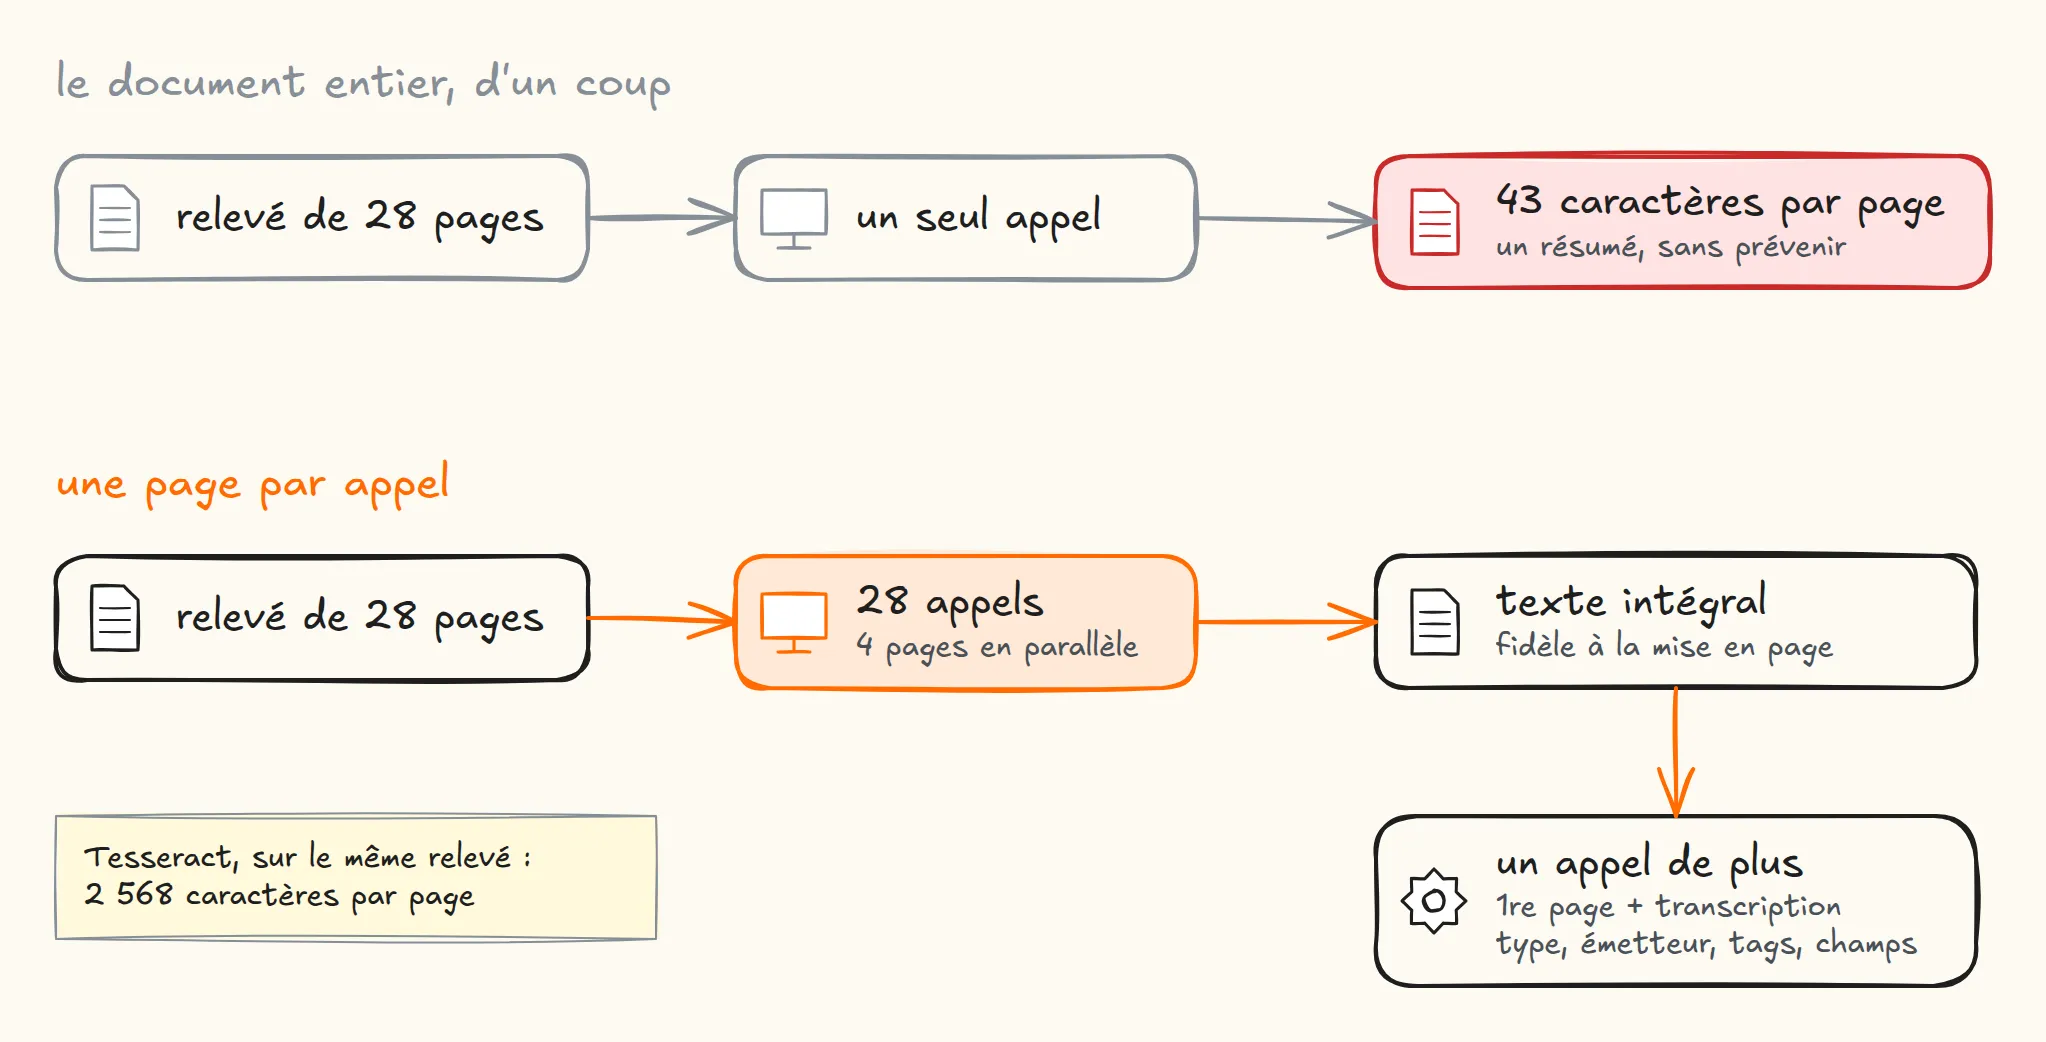
Le script découpe donc le PDF : 28 appels (4 en parallèle) transcrivent chaque page avec google/gemini-3.1-flash-lite via OpenRouter. C’est aussi le modèle de l’IA intégrée de Paperless, où gemini-2.5-flash-lite restait bloqué sur un des appels.
Le prompt de transcription (PROMPT_PAGE), à température 0 en JSON strict {"texte": "..."}, impose quatre consignes :
- Fidélité intégrale : « Rends en français tout le contenu lisible de cette page, fidèlement et intégralement, pas un résumé. » Toute autre langue est traduite.
- Reproduction exacte : « Reproduis EXACTEMENT, sans les traduire ni les reformuler : les nombres, dates, montants, numéros, références et noms propres (forme latine quand la page l’imprime). N’invente rien et écris [illisible] là où le texte ne se lit pas. »
- Organisation spatiale : « Reproduis l’organisation propre à la page, ne lui en impose aucune — un texte continu reste un texte continu, un tableau reste un tableau, un formulaire conserve ses paires clé-valeur. Ne rapproche jamais ce que la page sépare, ne sépare jamais ce que la page réunit, et un élément douteux reste isolé. » Sur un bilan sanguin de 49 valeurs, aucun nombre ne gardait ses voisins de ligne sur 20 passes sans cette clause, contre 68 % avec.
- Pages blanches : répondre exactement
{"texte": "[page vierge]"}, sans jamais renvoyer de texte vide pour une page encrée.
La détection des pages blanches s’appuie aussi sur la densité de pixels non blancs :
- Sous 0,1 % d’encre, la page est déclarée vierge d’office sans appel API.
- Au-dessus de 2 %, une réponse « vierge » du modèle est rejetée pour nouvelle lecture.
- Après trois réponses « vierge » consécutives sur une page encrée, le script l’accepte (photo, tampon, fond graphique sans texte).
Un second prompt (PROMPT_META) reçoit la première page et la transcription complète pour renseigner le type, le correspondant, le titulaire et la date d’établissement. Il choisit dans les listes existantes ou renvoie null : choisir le voisin le plus proche est interdit. Une métadonnée modifiée manuellement dans l’interface n’est plus jamais écrasée. Le script écarte un document après trois échecs et coupe le traitement si la dépense quotidienne dépasse 10 $.
L’archive transformée en base de données
Paperless permet d’associer des champs personnalisés aux documents. J’en ai configuré seize au total. Huit d’entre eux portent l’essentiel des automatisations :
| Champ | Ce qu’il contient |
|---|---|
montant | Le total d’une facture, d’un ticket, d’un bulletin, d’un relevé (614 documents) |
reference | Numéro de facture, de contrat ou de dossier, recopié tel quel (709) |
echeance, periode | Ce que la date d’émission ne dit pas : jusqu’à quand, pour quel mois (170 échéances) |
signe, cachet | Présence d’une signature ou d’un tampon, vérifiée par vision |
qualite | Signalement des pages à renumériser |
ocr_ecart | Les nombres détectés par Tesseract mais absents de la transcription du modèle de vision |
Le champ ocr_ecart constitue un garde-fou décisif. Le pire défaut d’un modèle n’est pas l’hallucination flagrante, mais un chiffre exact placé sur la mauvaise ligne. Le script extrait les nombres vus par Tesseract et les compare à la transcription vision : dès qu’un montant capté par l’OCR manque chez le modèle, l’écart est consigné dans ocr_ecart et le document est signalé pour contrôle.
Le circuit des pièces de ma société
J’exerce en freelance en SASU. Un dépôt Git dédié rassemble les consignes et les scripts de l’agent. Toutes les pièces reçues (factures, tickets, contrats ou captures d’écran de mails) atterrissent sans tri dans 00_A_TRAITER/.
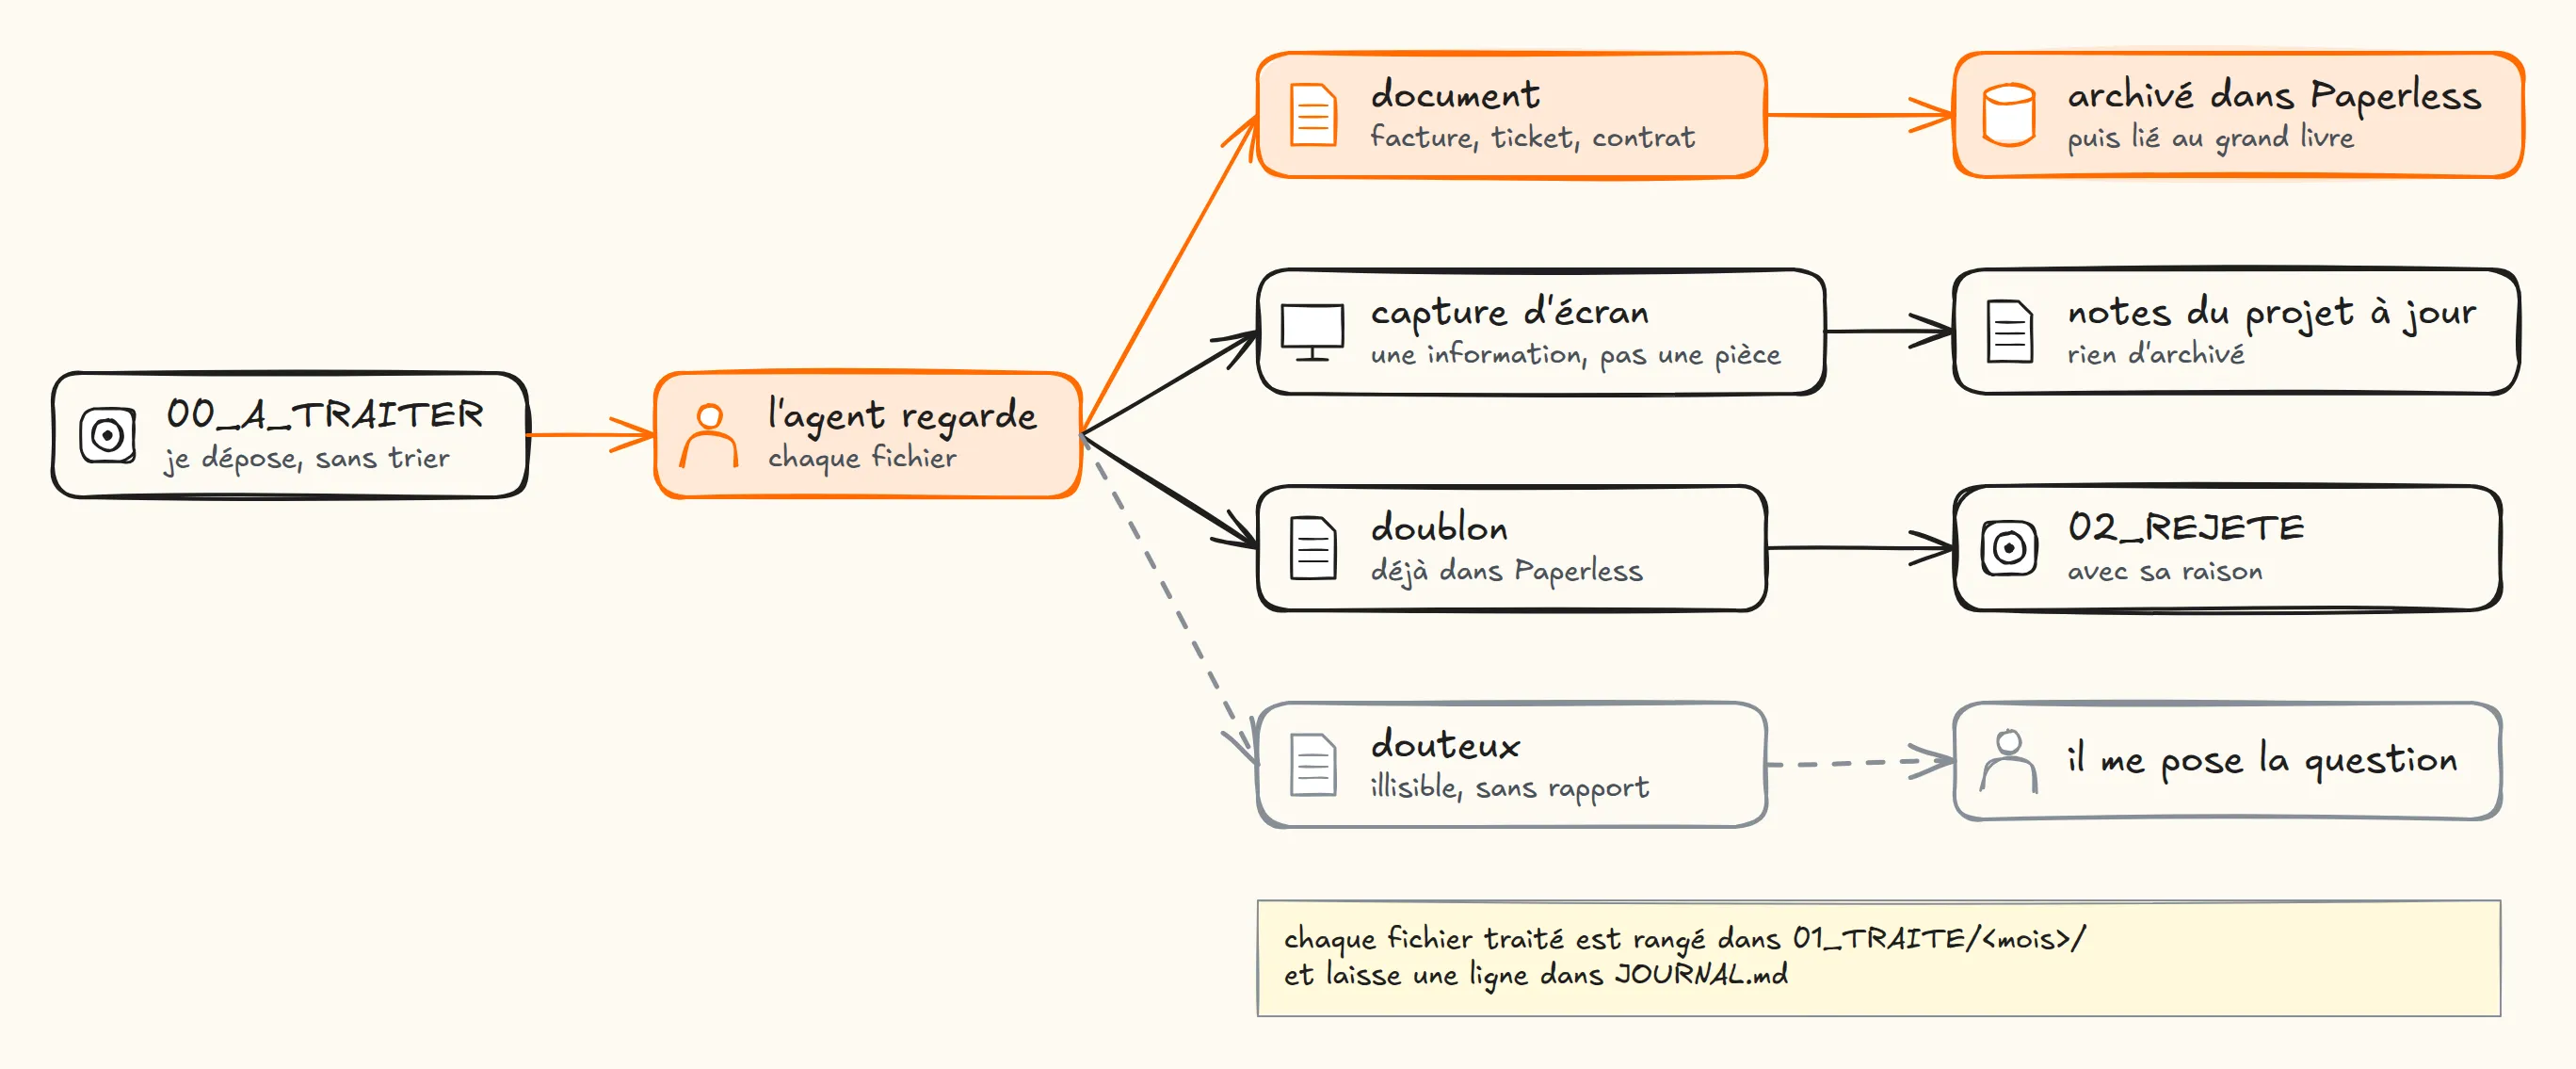
L’agent qualifie chaque fichier avant d’agir :
- Les pièces justificatives partent dans Paperless.
- Les captures d’écran mettent à jour les notes du projet sans être archivées.
- Les doublons sont rejetés dans
02_REJETE/(« déjà dans Paperless, doc 355 »). - Les fichiers douteux déclenchent une question pour moi.
Chaque fichier traité est rangé dans 01_TRAITE/<mois>/ et consigné dans un journal après confirmation d’enregistrement par Paperless.
Du document au justificatif dans Qonto par MCP
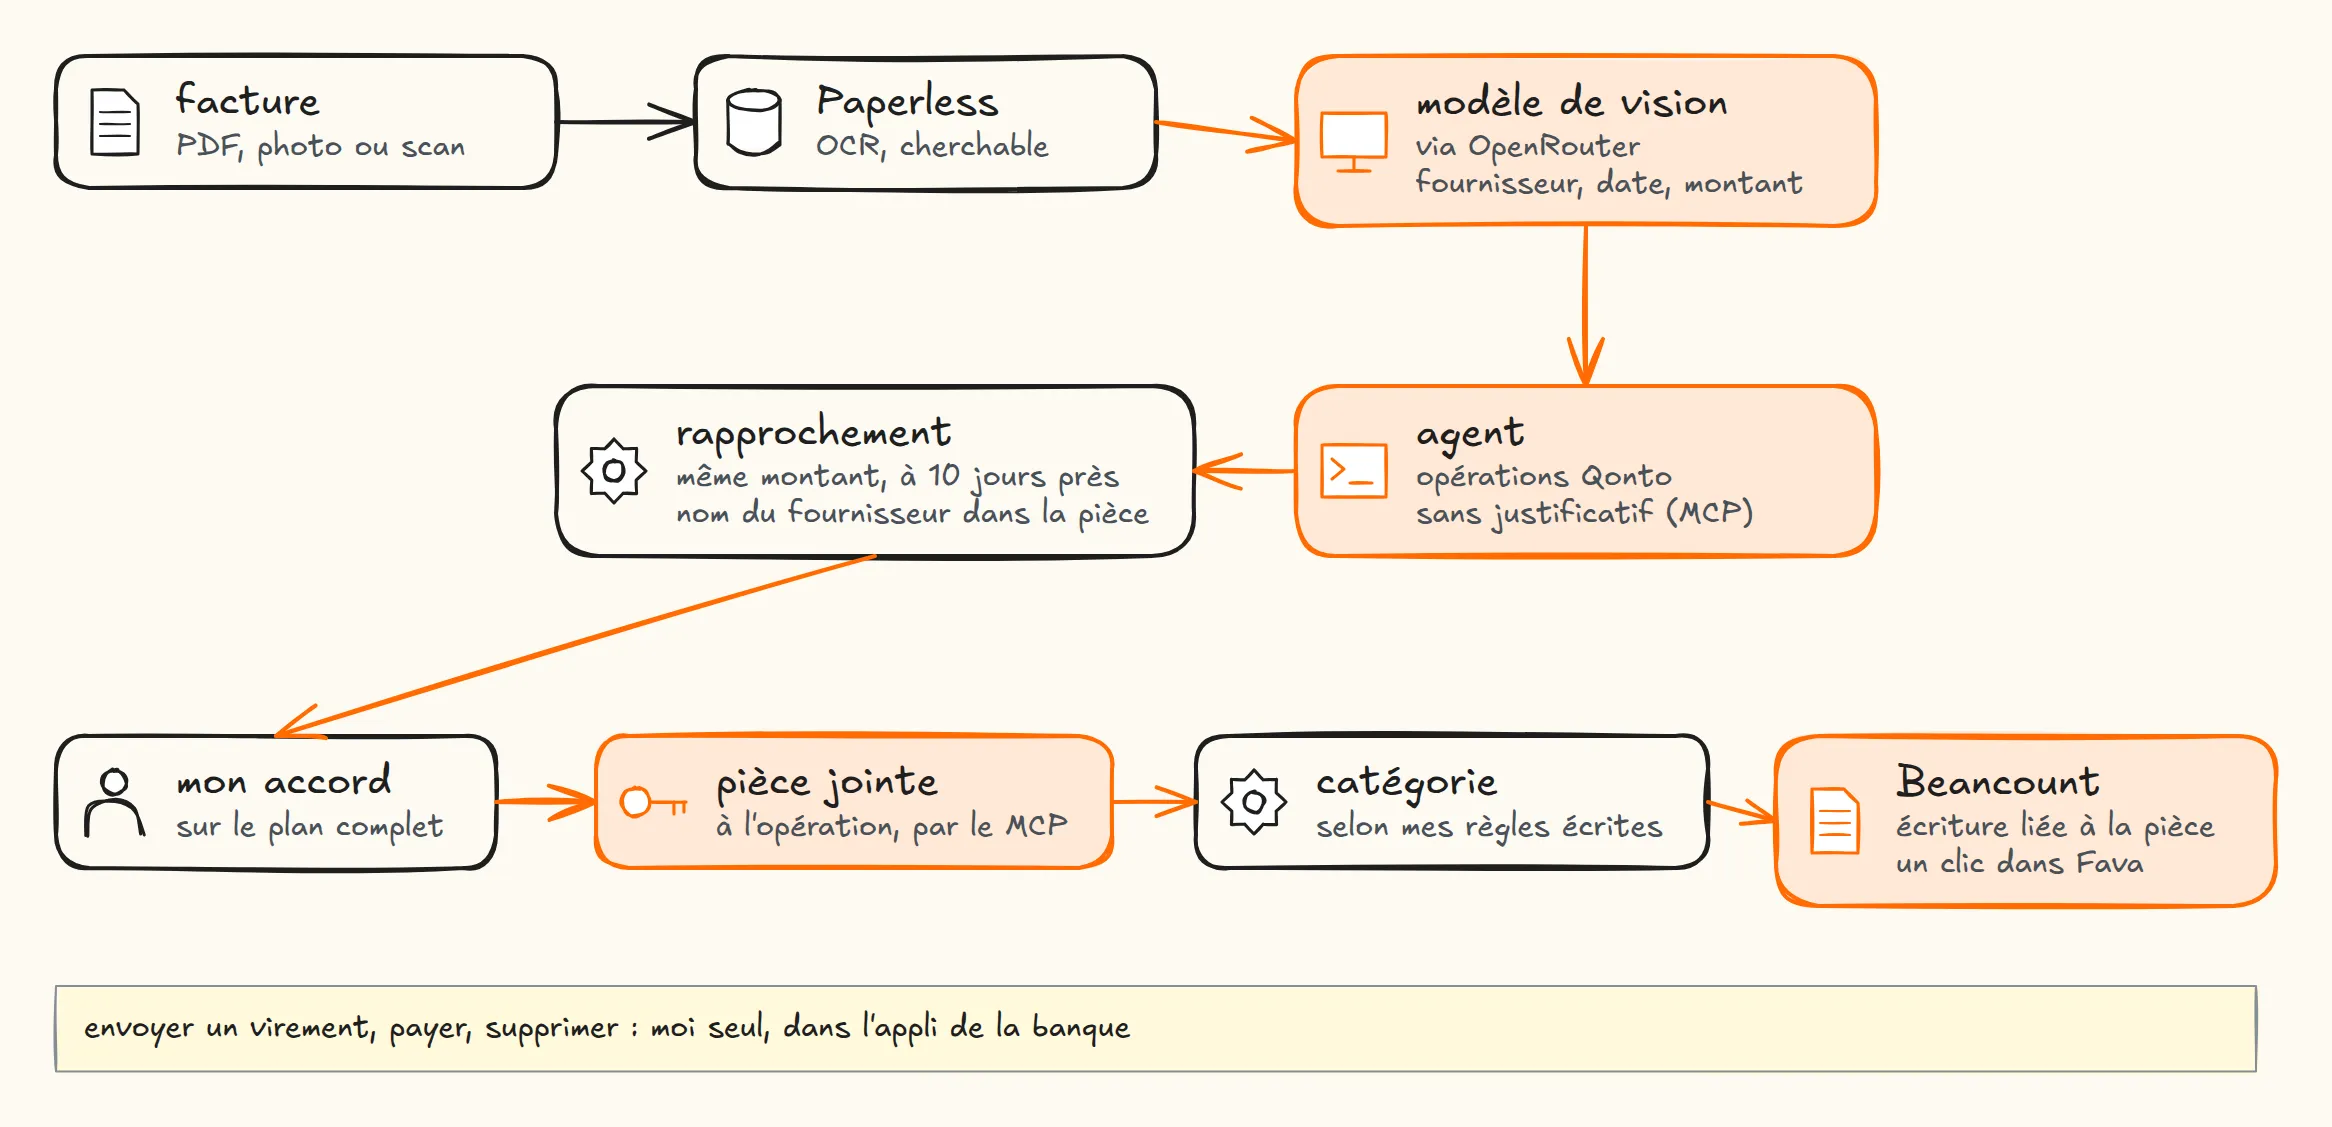
Le compte de la société est chez Qonto, qui fournit un serveur MCP officiel. L’agent liste les opérations sans justificatif et rapproche chaque pièce selon trois critères : montant identique, date concordante à dix jours près et présence du nom du fournisseur dans le document. Cette dernière condition évite d’attribuer une facture de 180 € à un prélèvement sans rapport du même montant.
L’agent me soumet son plan complet et attend mon accord. Dès validation, il demande à Qonto une URL de téléversement temporaire (15 minutes), dépose le fichier, lie la pièce à l’opération et applique la catégorie comptable selon mes règles écrites. L’agent n’a pas le droit d’envoyer un virement, de payer un fournisseur ni de supprimer quoi que ce soit : c’est une consigne écrite, pas un verrou technique, et ces actions restent les miennes, dans l’application bancaire, où l’agent me donne seulement le lien direct.
Paperless comme pivot de la comptabilité Beancount
Paperless est la référence unique de chaque pièce. Les 113 factures qui n’étaient déposées que dans Qonto y ont été rapatriées. Chaque écriture du grand livre Beancount intègre l’identifiant Paperless de sa pièce (199 écritures liées), accessible d’un clic dans Fava.
Le contrôle mensuel liste directement les opérations sans pièce. La gestion des notes de frais devient mécanique : sur 143 tickets de restaurant, deux couverts ou plus basculent en repas d’affaires, un seul en repas du gérant. Les indemnités kilométriques se calculent à partir des trajets enregistrés et du barème fiscal. La note de frais découle d’une requête sur des pièces vérifiées.
Côté perso : interroger l’archive en langage naturel
Pour mes documents personnels, l’agent combine les champs personnalisés plutôt qu’une simple recherche plein texte :
- « Ma copie du bail est-elle signée ? » Filtre sur l’étiquette « bail », vérification du champ
signe, lien direct vers l’exemplaire signé sans ouvrir le PDF. - « Qu’est-ce qui arrive à échéance dans les trois prochains mois ? » Requête sur
echeancepour lister assurances, garanties et abonnements. - « Quel montant d’électricité a été payé cette année, mois par mois ? » Agrégation des
montantpar mois sous forme de tableau, avec alerte siocr_ecartrepère une divergence. - « Prépare un dossier de location : trois derniers bulletins, dernier avis d’imposition et pièce d’identité. » Sélection des pièces et fusion en un PDF via Gotenberg, déjà présent dans la pile Paperless.
- « Retrouve la dernière analyse de sang. » Le tableau conserve son alignement et permet de comparer les valeurs d’une année sur l’autre.
Le homelab en profite aussi : la notice, la fiche technique et la déclaration de conformité de l’onduleur sont étiquetées homelab dans Paperless, où les agents de maintenance vont les consulter directement.
Qui a le droit de toucher à quoi
Un agent manipulant pièces d’identité et déclarations fiscales exige un cloisonnement net.
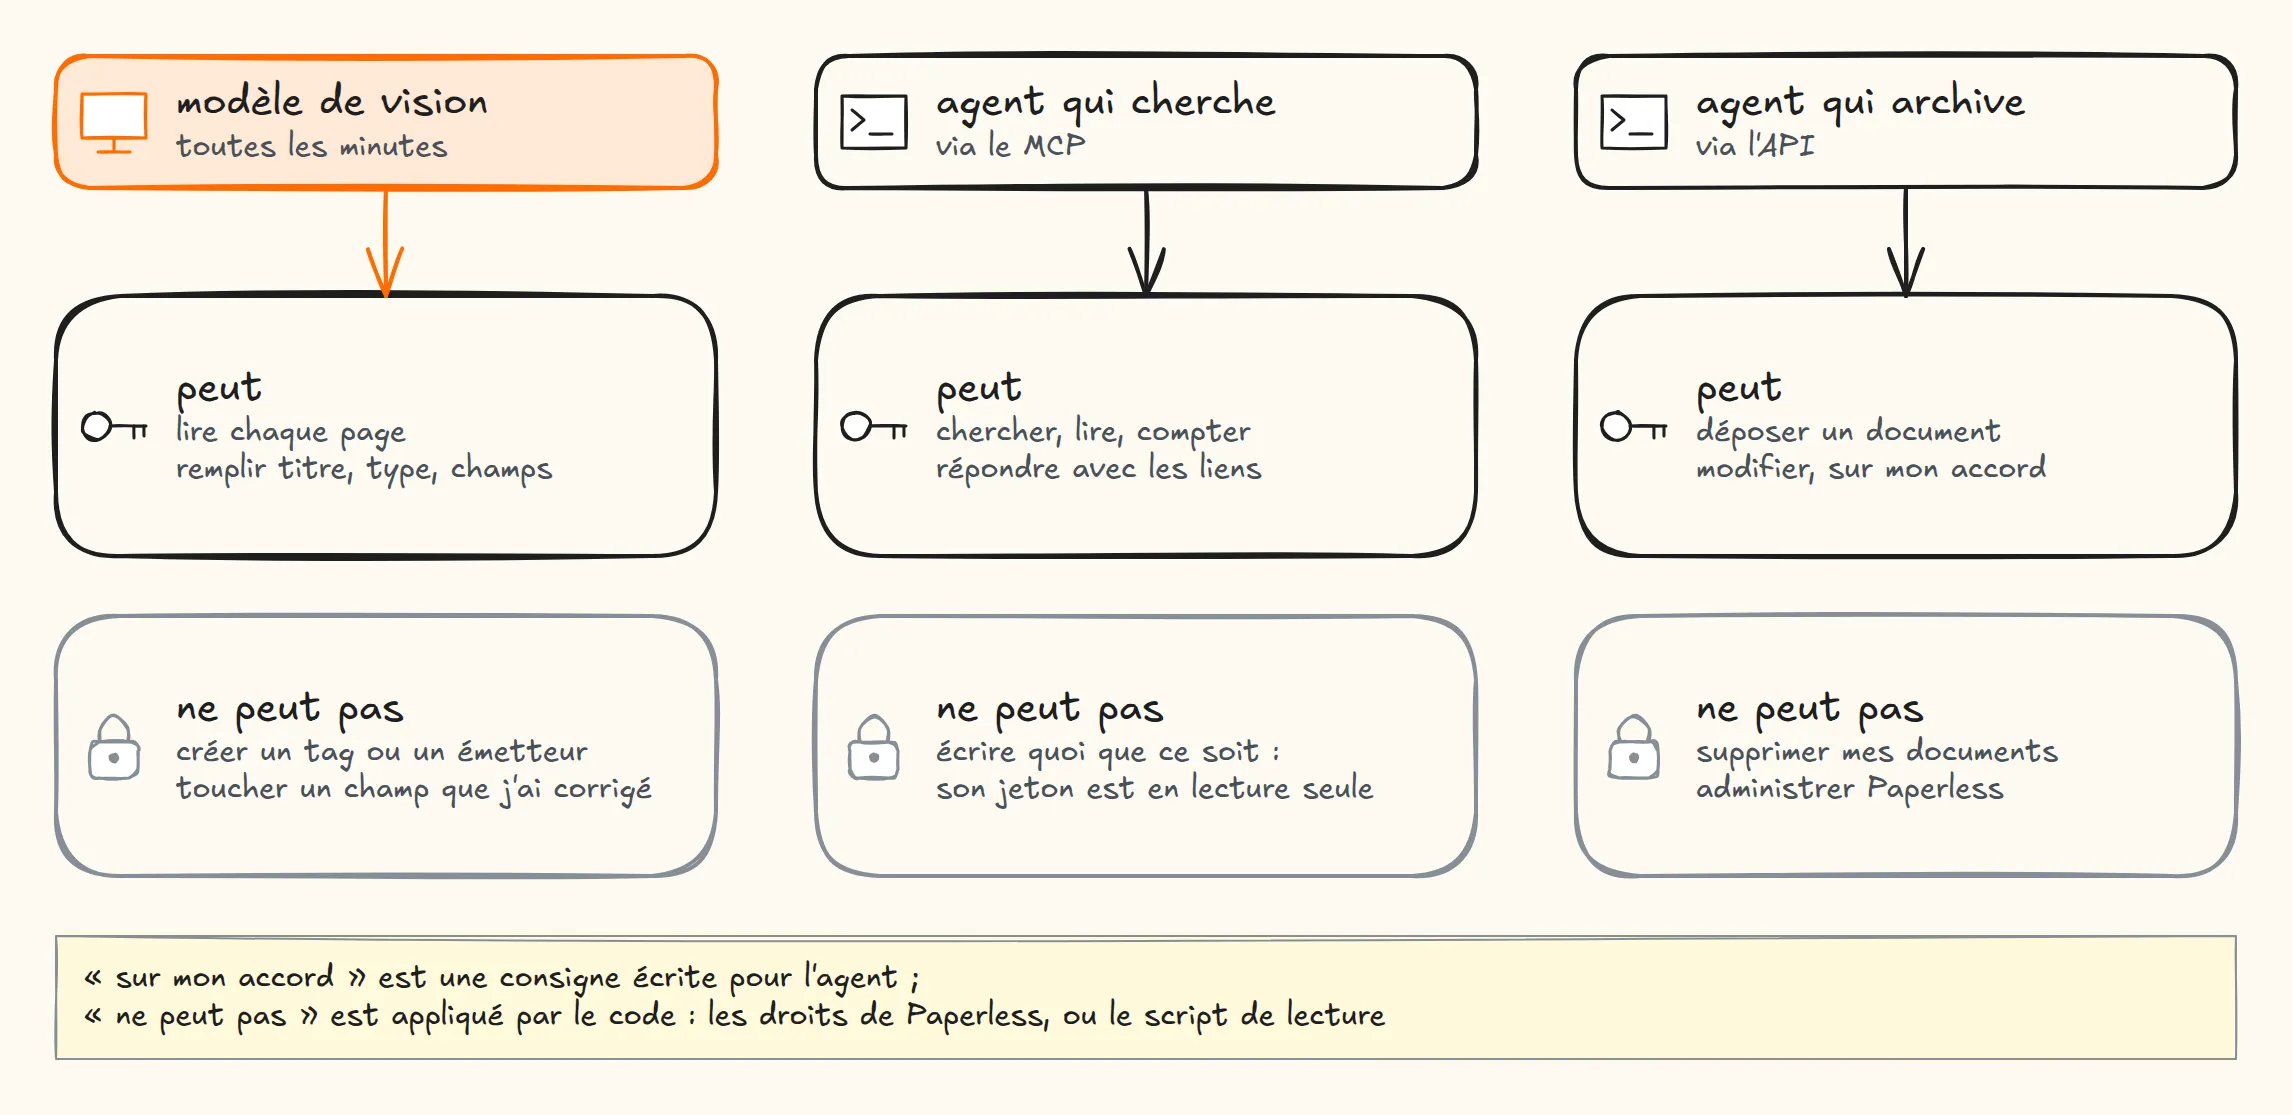
Les agents ont deux comptes dédiés sans privilège d’administration. L’agent d’interrogation passe par le serveur MCP (paperless-mcp) avec un jeton en lecture seule stricte : Paperless rejette toute écriture. L’agent d’archivage peut créer et modifier des pièces, mais pas les supprimer. L’interdiction de supprimer est un verrou Paperless ; l’obligation de me demander confirmation avant modification est une consigne écrite.
Un piège à connaître : un document non partagé avec un compte demeure invisible sans renvoyer d’erreur 403. L’agent voit simplement moins de résultats et peut fausser un calcul sans s’en apercevoir. Une règle d’automatisation partage donc chaque nouveau document avec les comptes des agents dès l’ingestion.
Douze modèles sur les mêmes pages : précision et coûts réels
Pour vérifier mon choix, j’ai confronté google/gemini-3.1-flash-lite à onze autres modèles sur OpenRouter avec les mêmes consignes, page par page. Le banc d’essai réunit onze pages de l’archive (tickets, factures, fiches techniques), soit 132 appels pour 0,86 dollar.
La fidélité est mesurée sur les données numériques : un nombre relevé par au moins la moitié des modèles est considéré exact. Chaque modèle est noté sur sa capacité à retrouver ces chiffres de consensus, tandis qu’une valeur isolée compte comme inventée.
| Modèle | Chiffres retrouvés | Inventés | Coût pour 1 000 pages | Secondes par page |
|---|---|---|---|---|
google/gemini-3-flash-preview | 99,1 % | 1 | 3,06 $ | 3,4 |
google/gemini-3.1-pro-preview | 98,6 % | 0 | 11,19 $ | 7,0 |
anthropic/claude-sonnet-5.5 | 98,2 % | 0 | 14,81 $ | 4,9 |
google/gemini-3.1-flash-lite (choisi) | 97,3 % | 3 | 1,50 $ | 2,7 |
anthropic/claude-haiku-5.5 | 97,3 % | 2 | 1,39 $ | 6,2 |
openai/gpt-6-luna-20260922 | 96,4 % | 5 | 1,05 $ | 10,1 |
qwen/qwen3-vl-235b-a22b-instruct | 95,9 % | 3 | 1,49 $ | 9,1 |
qwen/qwen3-vl-30b-a3b-instruct | 92,8 % | 4 | 0,95 $ | 11,2 |
google/gemini-2.5-flash-lite | 92,3 % | 7 | 0,56 $ | 2,0 |
google/gemini-3.5-flash-lite | 91,0 % | 3 | 2,08 $ | 2,0 |
google/gemini-3.5-flash | 90,5 % | 2 | 39,80 $ | 14,7 |
mistralai/mistral-small-3.2-24b-instruct | 77,9 % | 6 | 0,50 $ | 10,9 |
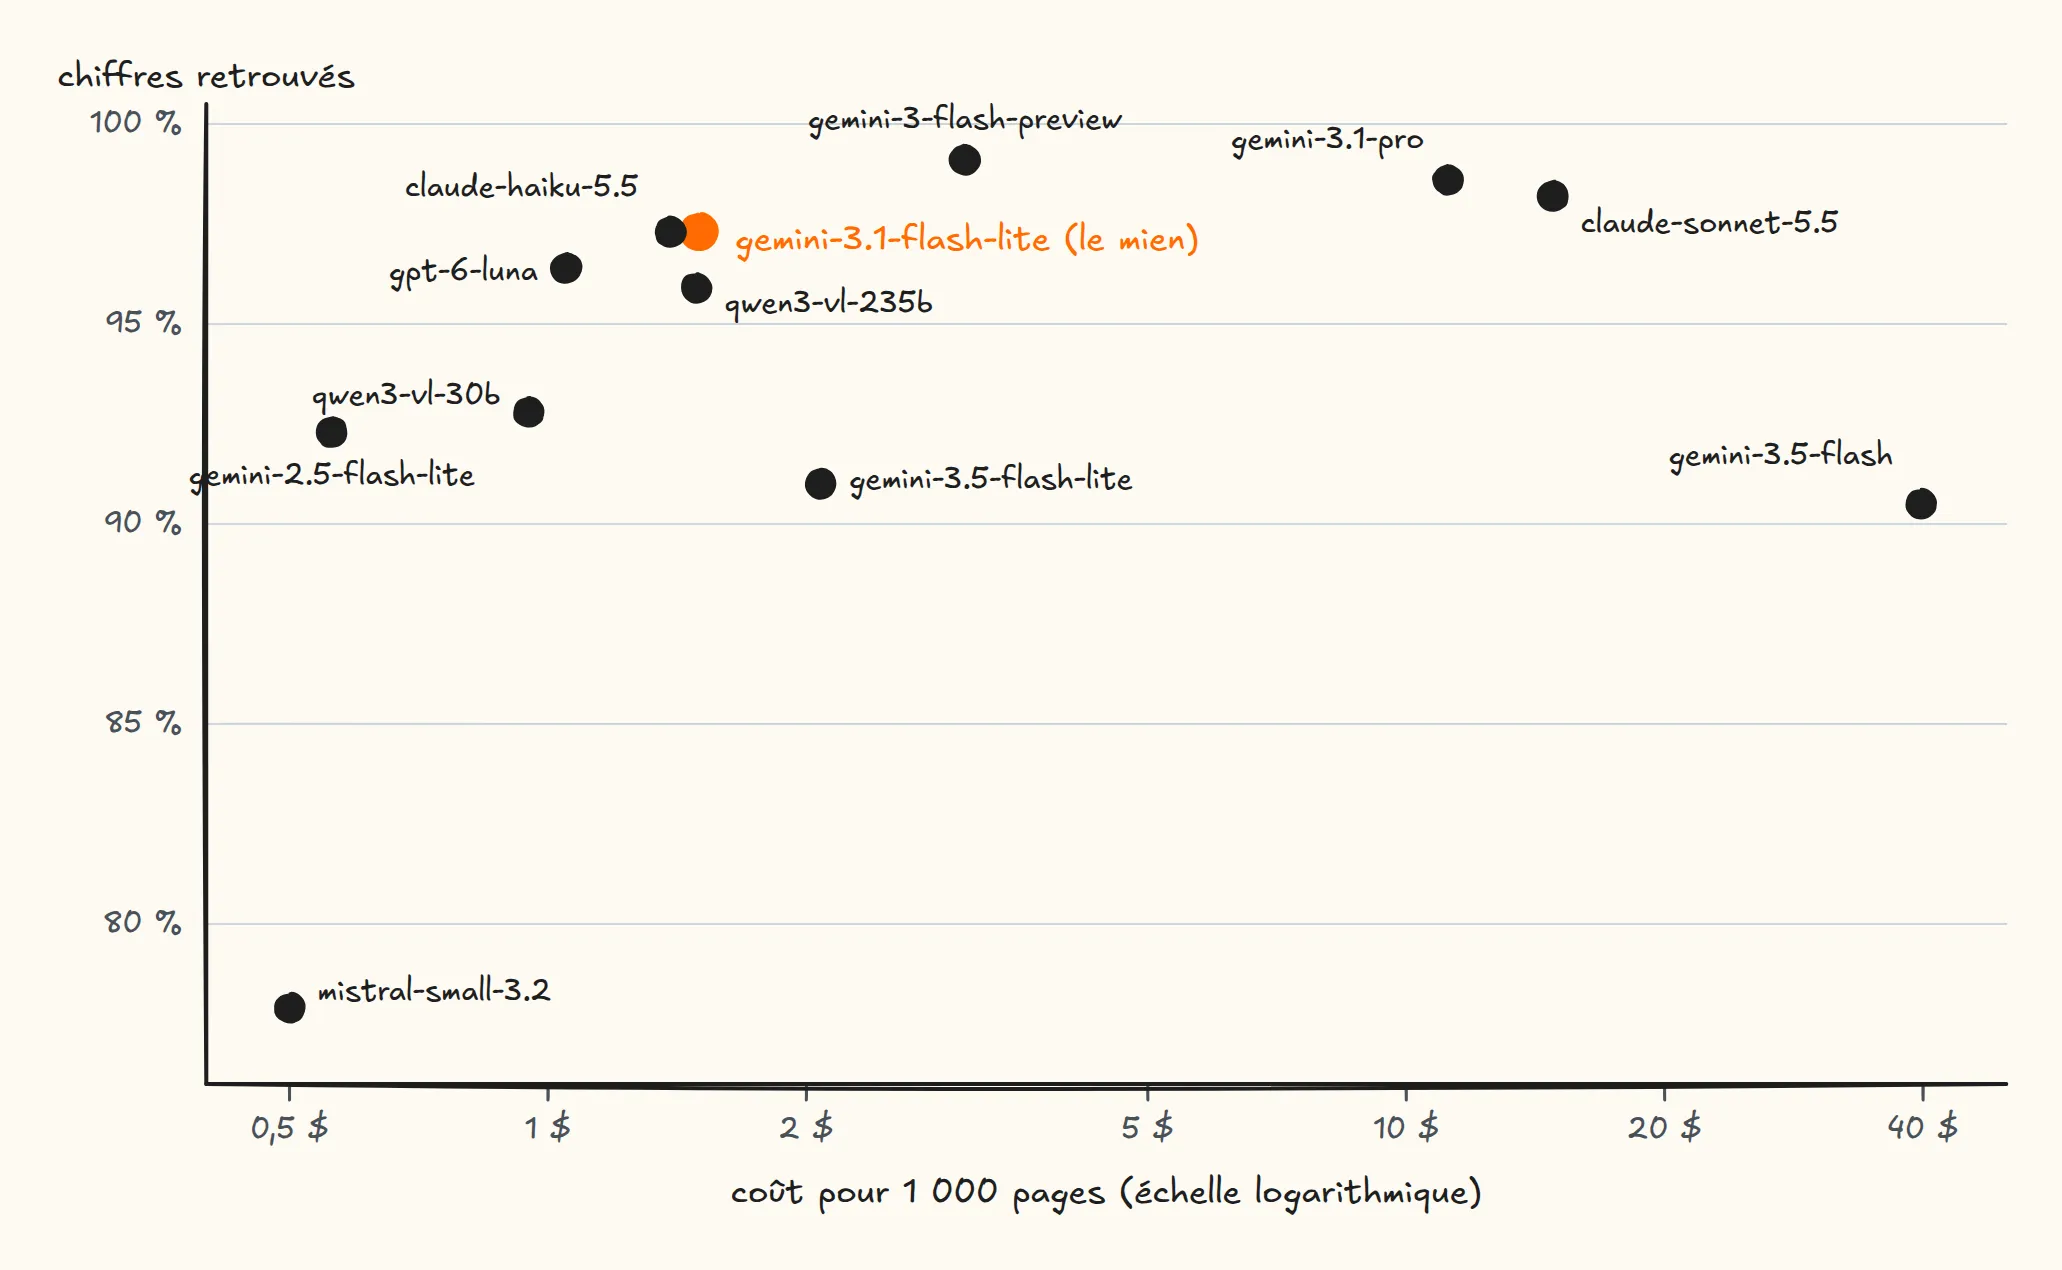
L’écart au sommet est minime : entre gemini-3.1-flash-lite à 1,50 $ les 1 000 pages et Claude Sonnet à 14,81 $, la fidélité varie d’un point pour un coût décuplé. Une version plus récente n’assure rien : gemini-3.5-flash-lite régresse face à la 3.1, et gemini-3.5-flash est à la fois le plus cher et l’un des moins fidèles.
Les pires erreurs ne viennent pas de lectures fausses, mais de boucles de génération infinies. Sur la notice de l’onduleur, mistral-small a saturé sa réponse de tabulations jusqu’à la limite de 8 000 tokens sans rendre un seul chiffre. Sur la seconde page d’une facture Amazon quasi vierge, gemini-3.5-flash a enchaîné des retours à la ligne facturés au prix fort. Mon script borne donc la taille des réponses et relance les pages tronquées.
Sur ce lot, gemini-3-flash-preview termine premier (99,1 % de fidélité pour 3 $ les 1 000 pages), un surcoût négligeable à l’échelle d’une archive personnelle.
Le coût d’usage et la frontière de la confidentialité
En exploitation réelle (relances, pages blanches et classification), l’indexation complète de l’archive (890 documents, 2 318 pages) revient à environ 5 $, soit un peu plus de 2 $ pour 1 000 pages A4. Le plafond à 10 $ par jour prévient toute boucle imprévue.
Ce fonctionnement implique une contrepartie explicite : chaque page quitte mon réseau sous forme d’image vers OpenRouter, pièces d’identité comprises. Les fichiers, la base PostgreSQL et les index restent chez moi, mais l’analyse visuelle dépend d’une API externe.
Pour garder un document hors de ce flux, il suffit de lui assigner le champ vision avant le passage du script. Je n’ai pas encore mesuré un modèle de vision local sur le même banc d’essai : tant que ce n’est pas fait, l’API distante reste mon compromis.
La GED devenue base de connaissances
Le classement manuel a disparu au profit d’un dépôt direct, et l’archive se consulte désormais par des questions en langage naturel pointant vers les pièces d’origine.
La supervision humaine reste indispensable sur les montants financiers sensibles, où une erreur de ligne paraît souvent cohérente. La suite de cette chaîne (le pilotage bancaire avec le MCP Qonto et la comptabilité Beancount) fera l’objet d’articles dédiés, dans la continuité de l’automatisation du CRA freelance.
Illustration de couverture générée avec Gemini 3.1 Flash Image, via OpenRouter ; le logo Paperless-ngx est la propriété du projet.